
Odin Lab · ODIN 101 — Digital Trust & Resilience
Q004 — Đánh giá rủi ro thế nào để không biến thành trò chấm điểm?
Odin Lab
Đánh giá rủi ro không phải là bài tập chấm điểm. Q004 giải thích cách dùng khả năng xảy ra, mức độ tác động, kiểm soát, bằng chứng và mức rủi ro còn lại để hỗ trợ quyết định tại Odin Lab Bank.
Odin Lab | ODIN 101 — Digital Trust & Resilience
Banking Technology • Risk • GRC • Audit • Resilience • AI
Mục tiêu của đánh giá rủi ro không phải là tạo ra một con số, mà là giúp đưa ra quyết định tốt hơn.
Trong Q001, chúng ta bắt đầu từ mục tiêu. Trong Q002, chúng ta phân biệt mối đe dọa, điểm yếu và rủi ro. Trong Q003, chúng ta học cách mô tả một rủi ro rõ ràng theo cấu trúc Nguyên nhân → Rủi ro → Hậu quả.
Đến đây, câu hỏi tiếp theo là: Rủi ro này quan trọng đến mức nào?
Đó là bước Assess — Đánh giá trong Odin Risk Management Method. Nghe có vẻ đơn giản, nhưng đây cũng là nơi quản trị rủi ro rất dễ biến thành một bài tập hành chính: chấm điểm 1–5, nhân hai con số, tô màu xanh–vàng–đỏ rồi kết thúc.
Nếu sau đó người ra quyết định vẫn chưa biết rủi ro nào cần xử lý trước, có cần đầu tư thêm hay mức rủi ro hiện tại có chấp nhận được hay không, thì việc đánh giá vẫn chưa hoàn thành nhiệm vụ.
Tại Odin Lab, mục tiêu của Risk Assessment rất đơn giản: hiểu mức độ rủi ro đủ tốt để đưa ra quyết định phù hợp.
1. Đánh giá rủi ro thực sự đang trả lời điều gì?
Một cách đơn giản, chúng ta đang cố trả lời hai câu hỏi: Khả năng rủi ro xảy ra là bao nhiêu? và Nếu xảy ra thì hậu quả nghiêm trọng đến đâu?
Hai yếu tố này thường được gọi là Likelihood — Khả năng xảy ra và Impact — Mức độ tác động. Đây là cách tiếp cận phổ biến trong CRISC của ISACA, NIST SP 800-30 và nhiều phương pháp quản trị rủi ro khác.
Nhưng điều quan trọng không phải thuộc hai thuật ngữ này. Điều quan trọng là đánh giá chúng dựa trên cơ sở nào.
2. Khả năng xảy ra không nên là một con số cảm tính
Trong một cuộc họp Risk Assessment, chúng ta có thể nghe câu: “Anh thấy khả năng xảy ra là 3 hay 4?”. Một người nói 3, người khác nói 4, cuối cùng mọi người thống nhất 3 để kết thúc cuộc họp.
Vấn đề không phải 3 hay 4. Vấn đề là: Vì sao là 3?
Khả năng xảy ra nên được xem xét dựa trên những thông tin có thể giải thích được: rủi ro đã từng xảy ra chưa, có sự cố tương tự hay không, hệ thống có tiếp xúc Internet không, điểm yếu có dễ bị khai thác không, có nhiều bước thủ công dễ sai không, hệ thống thay đổi thường xuyên đến mức nào, các kiểm soát hiện tại hoạt động ra sao và có cảnh báo hoặc sự cố suýt xảy ra nào gần đây không.
Như vậy, thay vì chỉ ghi “Likelihood = 4”, chúng ta nên có thể nói: Khả năng xảy ra: Cao, vì hệ thống đã xuất hiện nhiều cảnh báo đồng bộ trong sáu tháng gần đây, có hai thay đổi lớn sau lần kiểm thử phục hồi gần nhất và quá trình chuyển đổi vẫn còn một số bước thủ công.
3. Mức độ tác động phải quay lại mục tiêu
Tương tự, Impact không nên được đánh giá bằng cảm giác: “Cái này chắc High.” Câu hỏi phải là: Impact lên cái gì?
Một sự cố công nghệ có thể ảnh hưởng tới dịch vụ khách hàng, giao dịch, dữ liệu, tài chính, nghĩa vụ pháp lý, uy tín hoặc khả năng phục hồi của ngân hàng. Vì vậy, đánh giá tác động phải quay trở lại Objective — mục tiêu cần bảo vệ.
Một database bị gián đoạn 10 phút trong môi trường thử nghiệm có thể không đáng kể. Nhưng cùng 10 phút đó trên một dịch vụ thanh toán trọng yếu vào giờ cao điểm có thể là một vấn đề hoàn toàn khác.
Không nên đánh giá Impact của một thành phần công nghệ nếu chưa biết thành phần đó đang phục vụ dịch vụ nào.
4. Ví dụ tại Odin Lab Bank
Giả sử Odin Lab Bank có một dịch vụ thanh toán số quan trọng. Risk scenario được mô tả như sau:
Bởi vì dữ liệu tại site dự phòng chưa được kiểm thử đầy đủ sau thay đổi, dữ liệu có thể không ở trạng thái sử dụng được khi cần chuyển đổi, dẫn đến dịch vụ thanh toán không phục hồi trong thời gian yêu cầu và làm gián đoạn giao dịch khách hàng.
Để đánh giá khả năng xảy ra, không nên hỏi ngay “mấy điểm?”. Cần xem lần kiểm thử phục hồi gần nhất là khi nào, sau đó hệ thống đã thay đổi bao nhiêu lần, đã từng có lỗi replication chưa, monitoring có đầy đủ không, cảnh báo có được xử lý không và còn bước thủ công nào trong quá trình recovery.
Để đánh giá tác động, cần xem dịch vụ này quan trọng đến mức nào, RTO yêu cầu bao nhiêu, nếu không phục hồi được thì bao nhiêu khách hàng và giao dịch có thể bị ảnh hưởng, có nghĩa vụ báo cáo hay không và có kéo theo các dịch vụ khác hay không.

5. Một Risk Score không kể hết câu chuyện
Giả sử chúng ta sử dụng ma trận 5 × 5. Hai rủi ro cùng có thể nằm trong vùng đỏ, nhưng một rủi ro có khả năng xảy ra cao và tác động trung bình, trong khi rủi ro còn lại có khả năng xảy ra thấp hơn nhưng tác động rất cao.
Một sự cố nhỏ xảy ra thường xuyên có thể cần tự động hóa, sửa quy trình hoặc tăng khả năng phát hiện. Một sự cố hiếm gặp nhưng nếu xảy ra có thể làm dừng một dịch vụ trọng yếu nhiều giờ lại có thể cần thay đổi kiến trúc, đầu tư dự phòng hoặc kiểm thử phục hồi nghiêm ngặt hơn.
Risk Score là công cụ hỗ trợ so sánh. Nó không thay thế tư duy quản trị.
6. Heatmap cũng chỉ là bản đồ
Heatmap rất hữu ích vì giúp người quản lý nhanh chóng nhìn thấy khu vực có nhiều rủi ro cao. Nhưng một ô màu đỏ không tự trả lời được: có cần đầu tư thêm không, đầu tư bao nhiêu, có giải pháp nào hiệu quả hơn không, ai chịu trách nhiệm, có thể chấp nhận trong một thời gian hay không và nếu chấp nhận thì cần điều kiện gì.
Vì vậy, heatmap đúng nghĩa là bản đồ để định hướng cuộc thảo luận, không phải quyết định cuối cùng.
7. Inherent Risk và Residual Risk nên hiểu đơn giản thế nào?
Inherent Risk — Rủi ro vốn có là mức rủi ro khi chưa xem xét tác dụng của các biện pháp kiểm soát hiện tại. Residual Risk — Rủi ro còn lại là mức rủi ro sau khi đã xem xét hiệu quả của các biện pháp kiểm soát.
Ví dụ, một dịch vụ ngân hàng số kết nối Internet, xử lý dữ liệu nhạy cảm và phục vụ số lượng lớn khách hàng có thể có mức rủi ro vốn có cao. Nhưng nếu ngân hàng đã triển khai MFA, quản lý tài khoản đặc quyền, phân vùng mạng, giám sát, EDR, WAF, hardening và kiểm thử an ninh, mức rủi ro còn lại có thể thấp hơn đáng kể.
Nhưng có một từ rất quan trọng trong câu trên: “thực sự”.
8. Đừng giảm Risk Score chỉ vì “đã có Control”
Đây là một trong những sai lầm nguy hiểm nhất trong đánh giá rủi ro. Có backup không có nghĩa là restore được. Có DR site không có nghĩa là phục hồi được dịch vụ. Có firewall không có nghĩa là cấu hình đúng. Có policy không có nghĩa là policy được thực hiện.
Đó là lý do trong Odin Risk Management Method, sau Control — Kiểm soát là Evidence — Bằng chứng. Không nên giảm mức rủi ro chỉ vì control tồn tại trên giấy. Phải có cơ sở để tin rằng control đang hoạt động.
Có Control không đồng nghĩa với Control có hiệu quả.
9. Hãy dùng bằng chứng để đánh giá tốt hơn
Không phải rủi ro nào cũng có đủ dữ liệu thống kê, nhưng phần lớn tổ chức vẫn có nhiều bằng chứng hơn chúng ta tưởng: lịch sử sự cố, sự cố suýt xảy ra, monitoring, cảnh báo an ninh, dữ liệu vulnerability, kết quả backup/restore, kết quả diễn tập DR, audit findings, thống kê availability, sự cố của nhà cung cấp hoặc tỷ lệ lỗi sau thay đổi.
Mục tiêu không phải biến Risk Management thành môn thống kê. Mục tiêu là giảm việc đánh giá hoàn toàn dựa trên cảm giác.
10. Impact nên tận dụng Business Impact Analysis
Đối với những dịch vụ quan trọng, chúng ta thường đã có nhiều thông tin từ Business Impact Analysis — BIA: RTO, RPO, mức độ quan trọng của dịch vụ, các dependency, ảnh hưởng tới khách hàng, ảnh hưởng tài chính và nghĩa vụ pháp lý.
Thay vì tạo một bộ tiêu chí Impact hoàn toàn tách biệt, Risk Assessment nên tận dụng các thông tin này. Đây cũng là cách nối IT Risk với Operational Resilience và IT BCP/DR.
11. Mỗi điểm số nên có một câu giải thích
Tại Odin Lab, tôi đề xuất Risk Register không chỉ có Likelihood = 4, Impact = 5, Risk Score = 20. Nên có thêm hai trường rất quan trọng: Vì sao Likelihood ở mức này? và Vì sao Impact ở mức này?
Ví dụ: Khả năng xảy ra: Cao — replication đã có ba lần cảnh báo trong sáu tháng, hệ thống có hai thay đổi lớn sau lần kiểm thử phục hồi gần nhất và quá trình recovery vẫn còn bước thủ công.
Và: Tác động: Rất cao — đây là dịch vụ thanh toán trọng yếu; nếu recovery thất bại, dịch vụ có thể vượt RTO và làm gián đoạn giao dịch khách hàng trên diện rộng.
Nếu lãnh đạo chỉ có thời gian đọc hai câu này mà không nhìn điểm số, họ vẫn hiểu được vấn đề. Đó là dấu hiệu của một Risk Assessment tốt.
12. Đừng tạo ra “độ chính xác giả”
Một rủi ro được ghi “Likelihood = 73%” không nhất thiết chính xác hơn “Likelihood = Cao” nếu 73% chỉ là một con số ước lượng không có dữ liệu đáng tin cậy phía sau. Tương tự, một con số thiệt hại rất chi tiết không có nhiều ý nghĩa nếu phương pháp tính không đủ chắc chắn.
Trong nhiều trường hợp, thang Thấp – Trung bình – Cao – Rất cao hoàn toàn phù hợp nếu định nghĩa rõ và sử dụng nhất quán. Điều chúng ta cần là độ tin cậy đủ để quyết định, không phải vẻ chính xác của con số.
13. Khi nào nên đánh giá định lượng?
Đánh giá định lượng hữu ích khi chúng ta có đủ dữ liệu và quyết định mang tính đầu tư: có nên đầu tư thêm cho resilience hay không, một giờ downtime ước tính ảnh hưởng bao nhiêu, biện pháp mới dự kiến giảm tổn thất bao nhiêu, hoặc chi phí của control có hợp lý so với mức rủi ro được giảm hay không.
Nhưng không phải mọi risk đều cần một mô hình định lượng phức tạp. Một nguyên tắc thực tế là: Mức độ chi tiết của Risk Assessment nên tương xứng với mức độ quan trọng của quyết định cần đưa ra.
14. Hai rủi ro cùng màu đỏ nhưng không giống nhau
Hãy quay lại Odin Lab Bank với hai rủi ro.
Risk A — Phishing: các cuộc tấn công xảy ra thường xuyên. Khả năng xảy ra cao, nhưng nếu MFA, email security và monitoring đang hoạt động tốt, tác động của từng trường hợp có thể được hạn chế.
Risk B — Recovery Failure: khả năng xảy ra thấp hơn, nhưng nếu một sự cố lớn xảy ra đúng lúc Recovery Site không thể phục hồi dịch vụ, Digital Payment Service có thể vượt RTO và gián đoạn trong thời gian dài. Tác động rất cao.
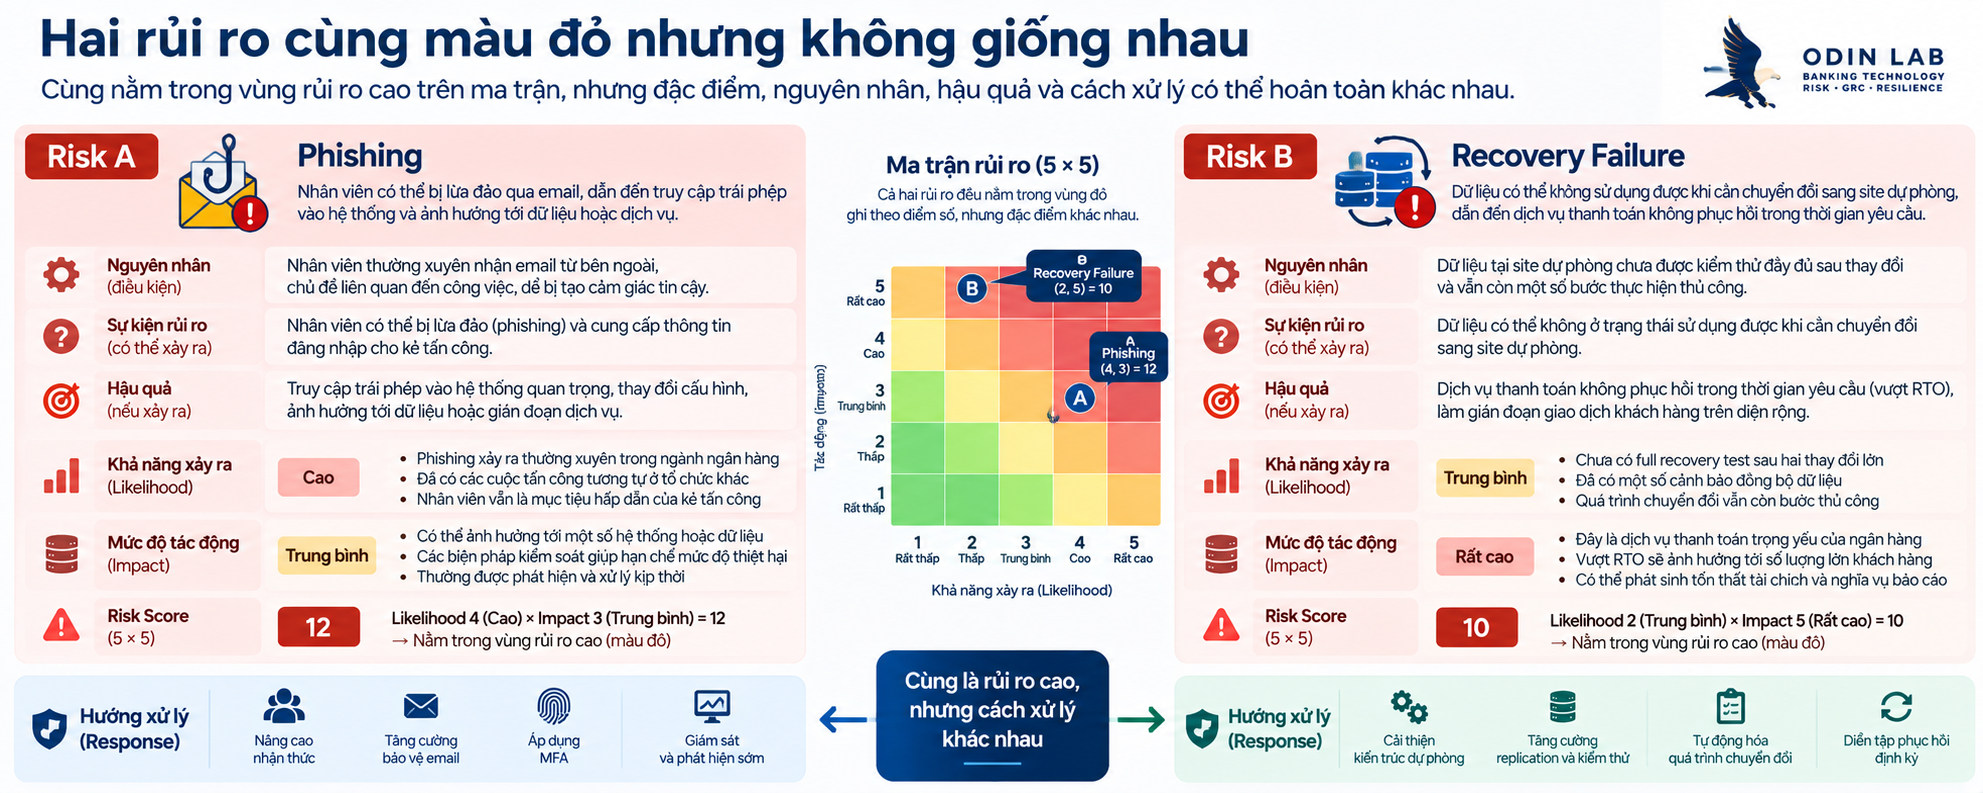
Phishing có thể cần nâng cao nhận thức, email security, MFA và monitoring. Recovery Failure có thể cần thay đổi kiến trúc, replication, automation và diễn tập phục hồi. Màu sắc giúp chúng ta nhìn thấy Risk. Context giúp chúng ta quyết định phải làm gì.
15. Điểm quan trọng cuối cùng: có chấp nhận được không?
Sau khi đánh giá xong, câu hỏi không phải “Risk Score là 16 à?” mà là: Mức rủi ro còn lại này có chấp nhận được không?
Risk Appetite có thể hiểu là mức độ rủi ro mà tổ chức sẵn sàng chấp nhận để theo đuổi mục tiêu. Risk Tolerance cụ thể hóa giới hạn mà tổ chức không muốn vượt qua trong một bối cảnh nhất định.
Nếu residual risk nằm trong giới hạn chấp nhận, management có thể quyết định accept. Nếu vượt giới hạn, cần hành động thêm. Lúc này Risk Assessment mới bắt đầu chuyển thành Risk Decision.
16. Năm câu hỏi của Odin cho một Risk Assessment
- Risk scenario đã được mô tả đủ rõ chưa?
- Khả năng xảy ra ở mức nào, và bằng chứng nào hỗ trợ đánh giá đó?
- Nếu xảy ra, mục tiêu hoặc dịch vụ bị ảnh hưởng ở mức nào, và vì sao?
- Các biện pháp kiểm soát hiện tại có thực sự hiệu quả không?
- Mức rủi ro còn lại có nằm trong giới hạn tổ chức chấp nhận không?
Nếu chưa trả lời được năm câu trên, chưa nên quá vội vàng chốt Risk Score.
17. Kết nối với Odin Risk Management Method
Trong Odin Method: Objective → Risk → Assess → Control → Evidence → Responsibility → Decision & Monitor → Learn.
Q004 tập trung vào bước Assess. Nhưng Assess không đứng riêng. Nó cần Objective rõ, cần Risk Statement tốt, cần hiểu Controls, cần Evidence để biết Controls có thực sự hiệu quả, và quan trọng nhất là phải dẫn tới Decision.
Risk Assessment không phải một bài tập chấm điểm. Nó là một bước trong vòng lặp ra quyết định.
Kết luận
Likelihood hữu ích. Impact hữu ích. Risk Matrix hữu ích. Heatmap cũng hữu ích. Nhưng tất cả đều chỉ là công cụ.
Một Risk Assessment tốt không kết thúc bằng câu “Risk này được 16 điểm”. Nó phải giúp trả lời câu hỏi quan trọng hơn: Chúng ta đã hiểu rủi ro này đủ rõ để quyết định phải làm gì chưa?
Nếu câu trả lời là chưa, Risk Assessment vẫn chưa hoàn thành.
Tại Odin Lab, mục tiêu của bước Assess rất đơn giản: Hiểu mức độ rủi ro đủ tốt để đưa ra quyết định phù hợp.
TURN RISK INTO VALUE.
Đọc tiếp trong ODIN 101
← Q003: Làm thế nào để mô tả rủi ro rõ ràng và không mơ hồ?
Bắt đầu từ Q001: Quản trị rủi ro thực sự bắt đầu từ đâu?
Đọc tiếp → Q005: Một kiểm soát tốt phải làm thay đổi rủi ro như thế nào?
Xem toàn bộ ODIN 101 — Digital Trust & Resilience →
Tài liệu tham khảo
ISACA — CRISC Exam Content Outline.
NIST SP 800-30 Rev.1 — Guide for Conducting Risk Assessments.
ISO 31000:2018 — Risk Management — Guidelines.
[…] ← Q004: Đánh giá rủi ro thế nào để không biến thành trò chấm điểm? […]